هوش مصنوعی
معرفی DeepSeek-V4.1-Flash: مدل هوشمندتر، سریعتر و کارآمدتر با درک بصری بومی
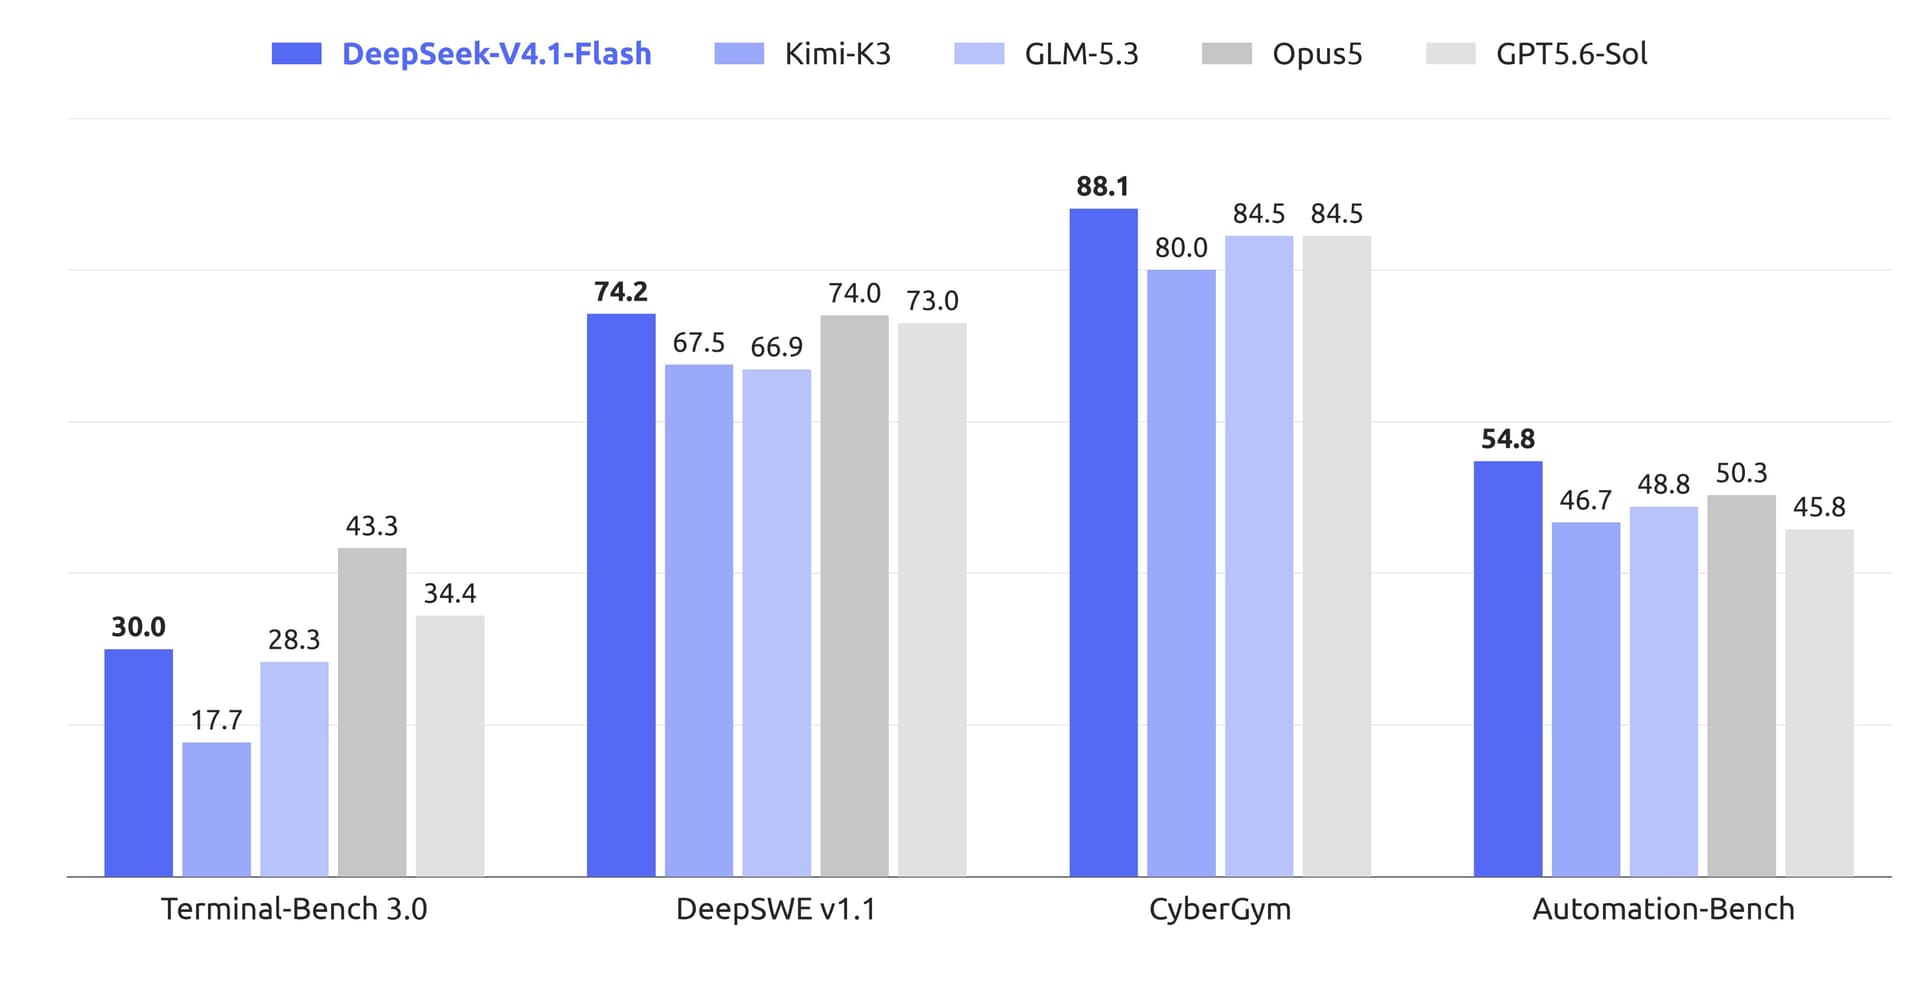
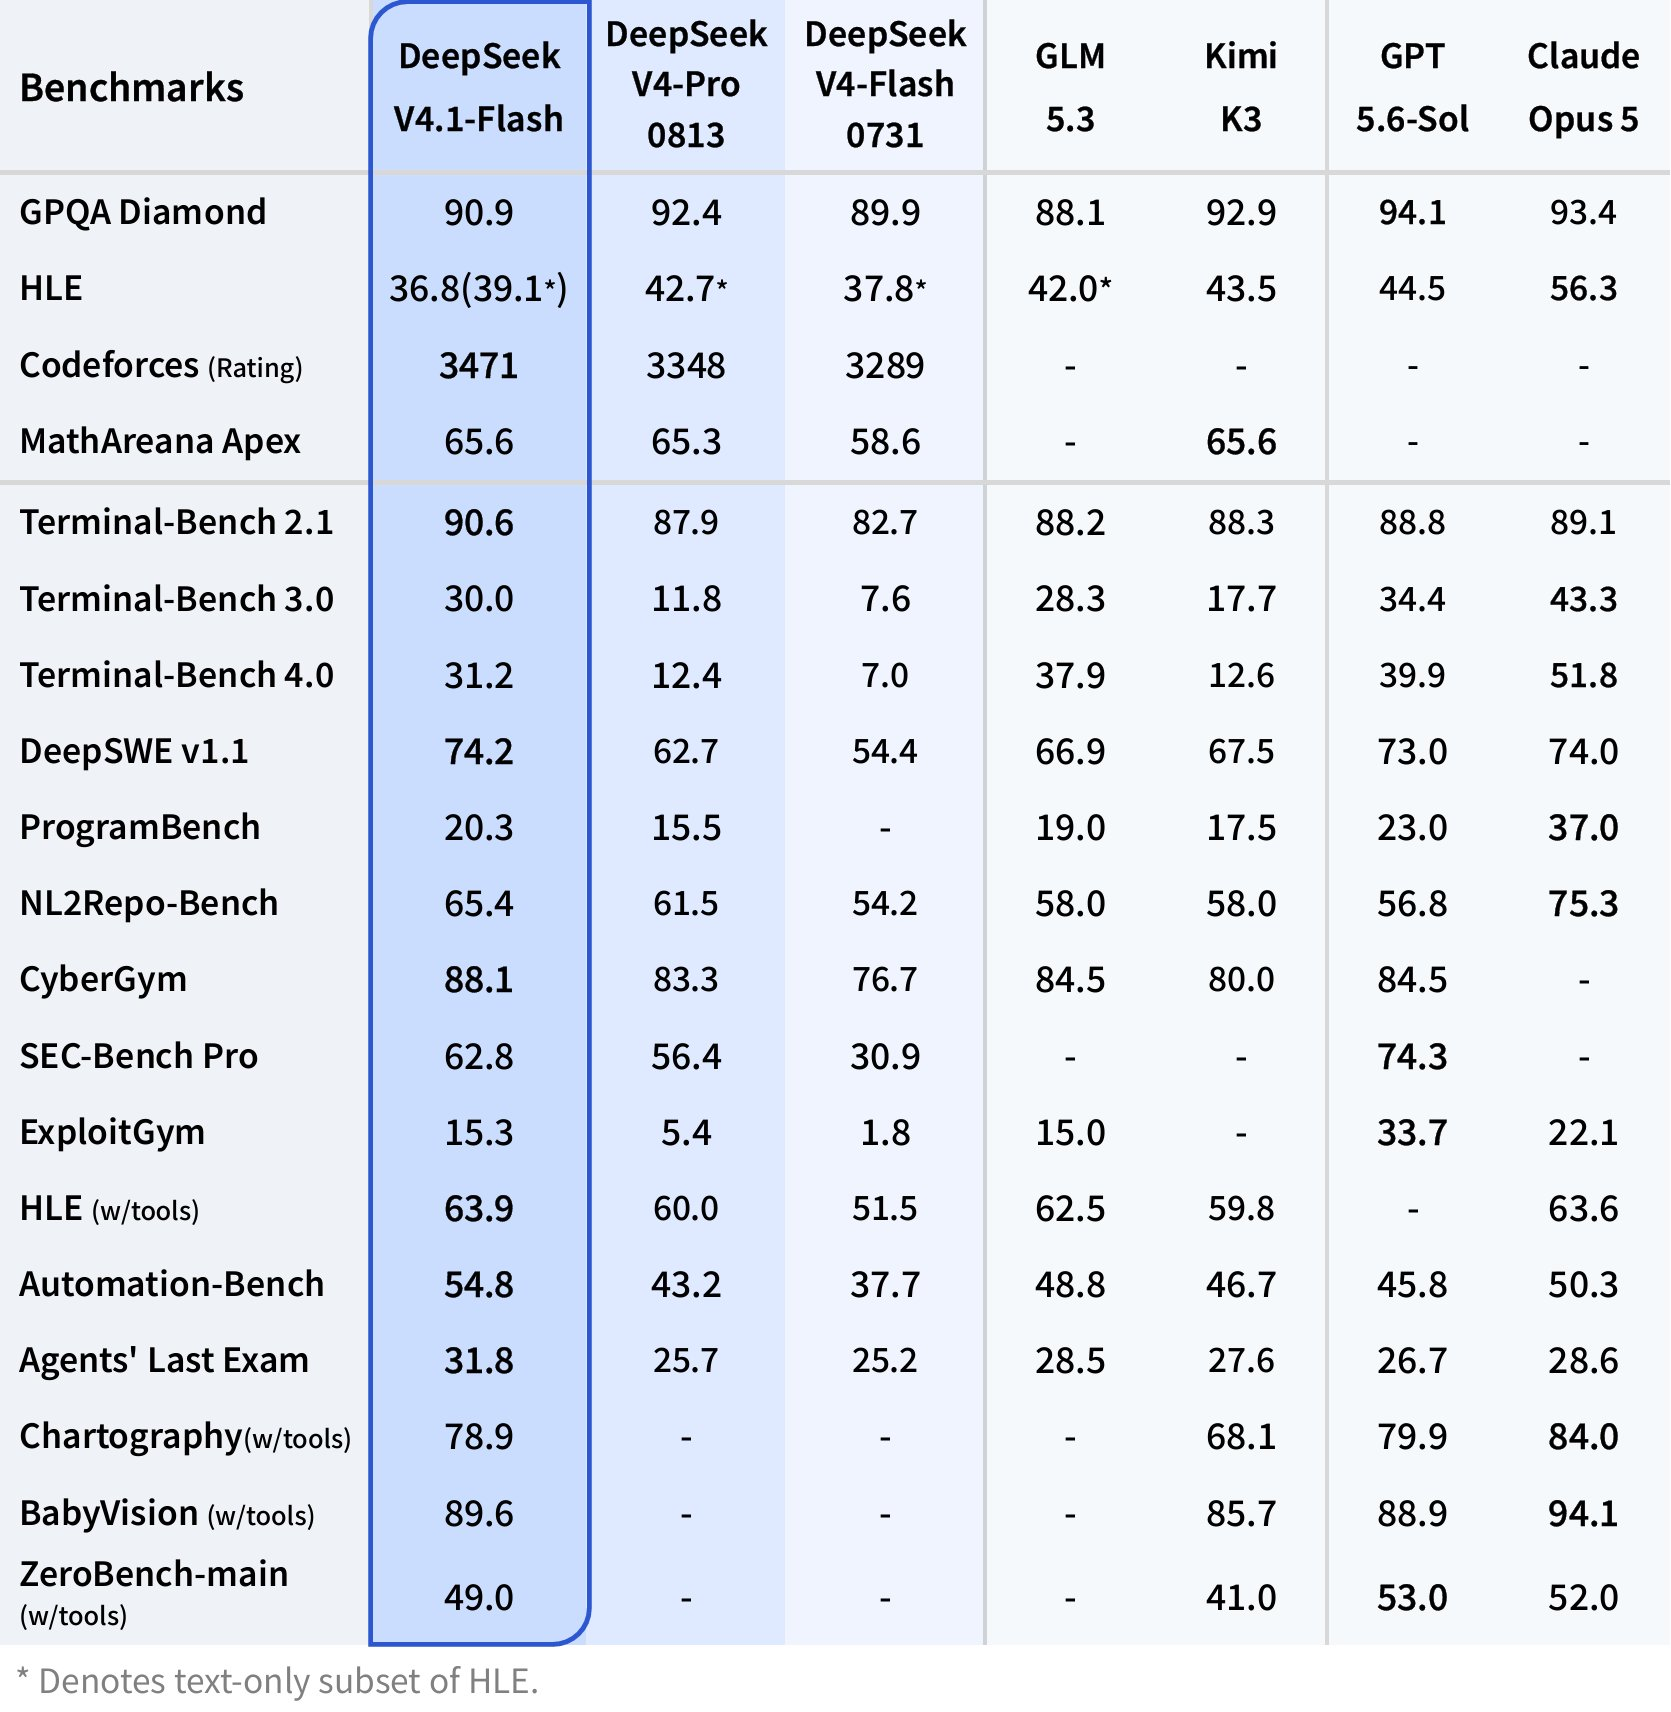
معماری نامتقارن DeepSeek-V4.1-Flash؛ هوش بیشتر با هزینه کمتر
- مدل Mixture-of-Experts (MoE) با ۵۵۲ میلیارد پارامتر
- معماری جدید Causal Encoder–Decoder: فقط ۸ میلیارد پارامتر فعال برای ورودی و ۱۶ میلیارد برای خروجی
- روشهای پیشآموزش جدید + تقویت یادگیری تقویتی در مقیاس بزرگ، نتایج بنچمارک را حتی از مدلهای پرچمدار مانند DeepSeek-V4-Pro جلوتر برده است.
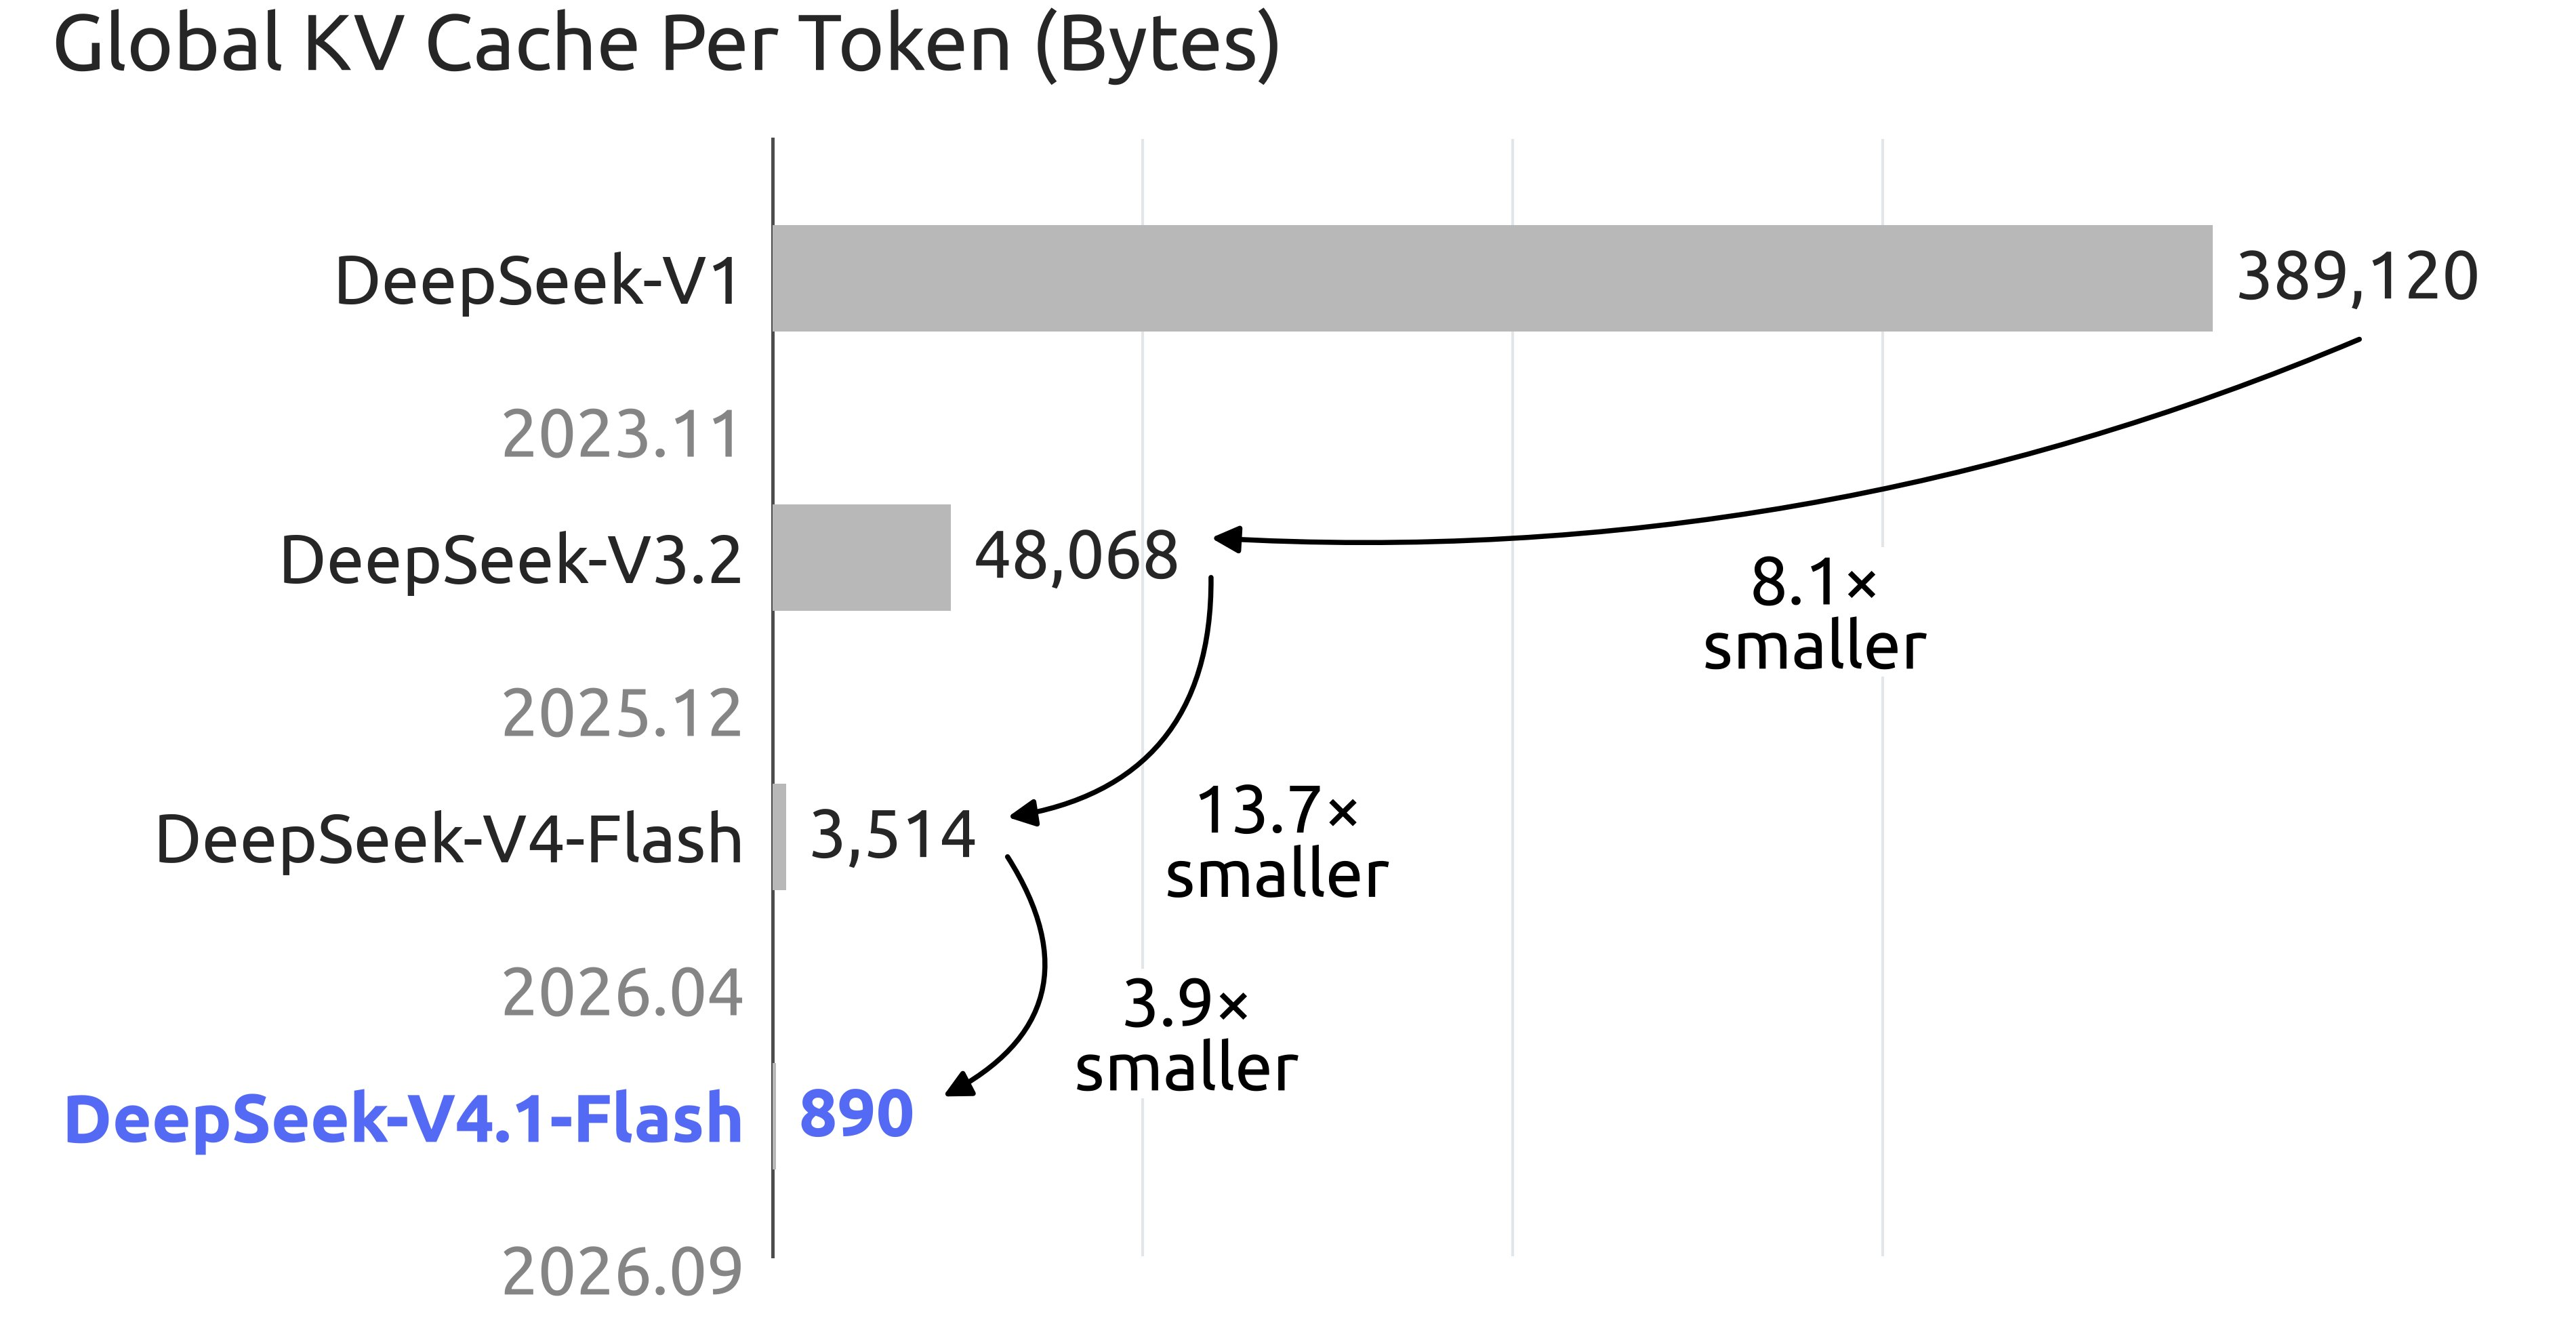
کاهش چشمگیر KV Cache (H2)
KV Cache کوچکتر = صرفهجویی بزرگتر
در مقایسه با نسل قبلی، KV Cache مدل V4.1-Flash نیاز دارد به:
- فقط ۱/۴ حافظه HBM
- فقط ۱/۸ فضای ذخیرهسازی SSD
هزینه Cache-hit بخش بزرگی از هزینههای عاملها (Agents) را تشکیل میدهد. فشردهسازی کش این هزینهها را به شکل قابلتوجهی کاهش میدهد.
دسترسی و پشتیبانی چندوجهی (H2)
DeepSeek-V4.1-Flash هماکنون در API دیپسیک فعال است
مدل را روی deepseek-flash تنظیم کنید. پشتیبانی بومی چندوجهی (Multimodal) دارد.
- مدلهای V4-Flash و V4-Flash-Vision-Exp بازنشسته شدهاند (برای سازگاری موقتاً به V4.1-Flash هدایت میشوند).
- تستهای مستقل نشان میدهد V4.1-Flash از نظر عملکرد، هزینه، سرعت و زمان کل اجرا از V4-Pro بهتر است. به همین دلیل V4-Pro نیز بهتدریج کنار گذاشته میشود.
- از ساعت ۰۴:۰۰ UTC تاریخ ۱۴ سپتامبر ۲۰۲۶، تمام درخواستهای deepseek-v4-pro به V4.1-Flash با نرخ جدید هدایت میشوند تا زمان عرضه V4.1-Pro.
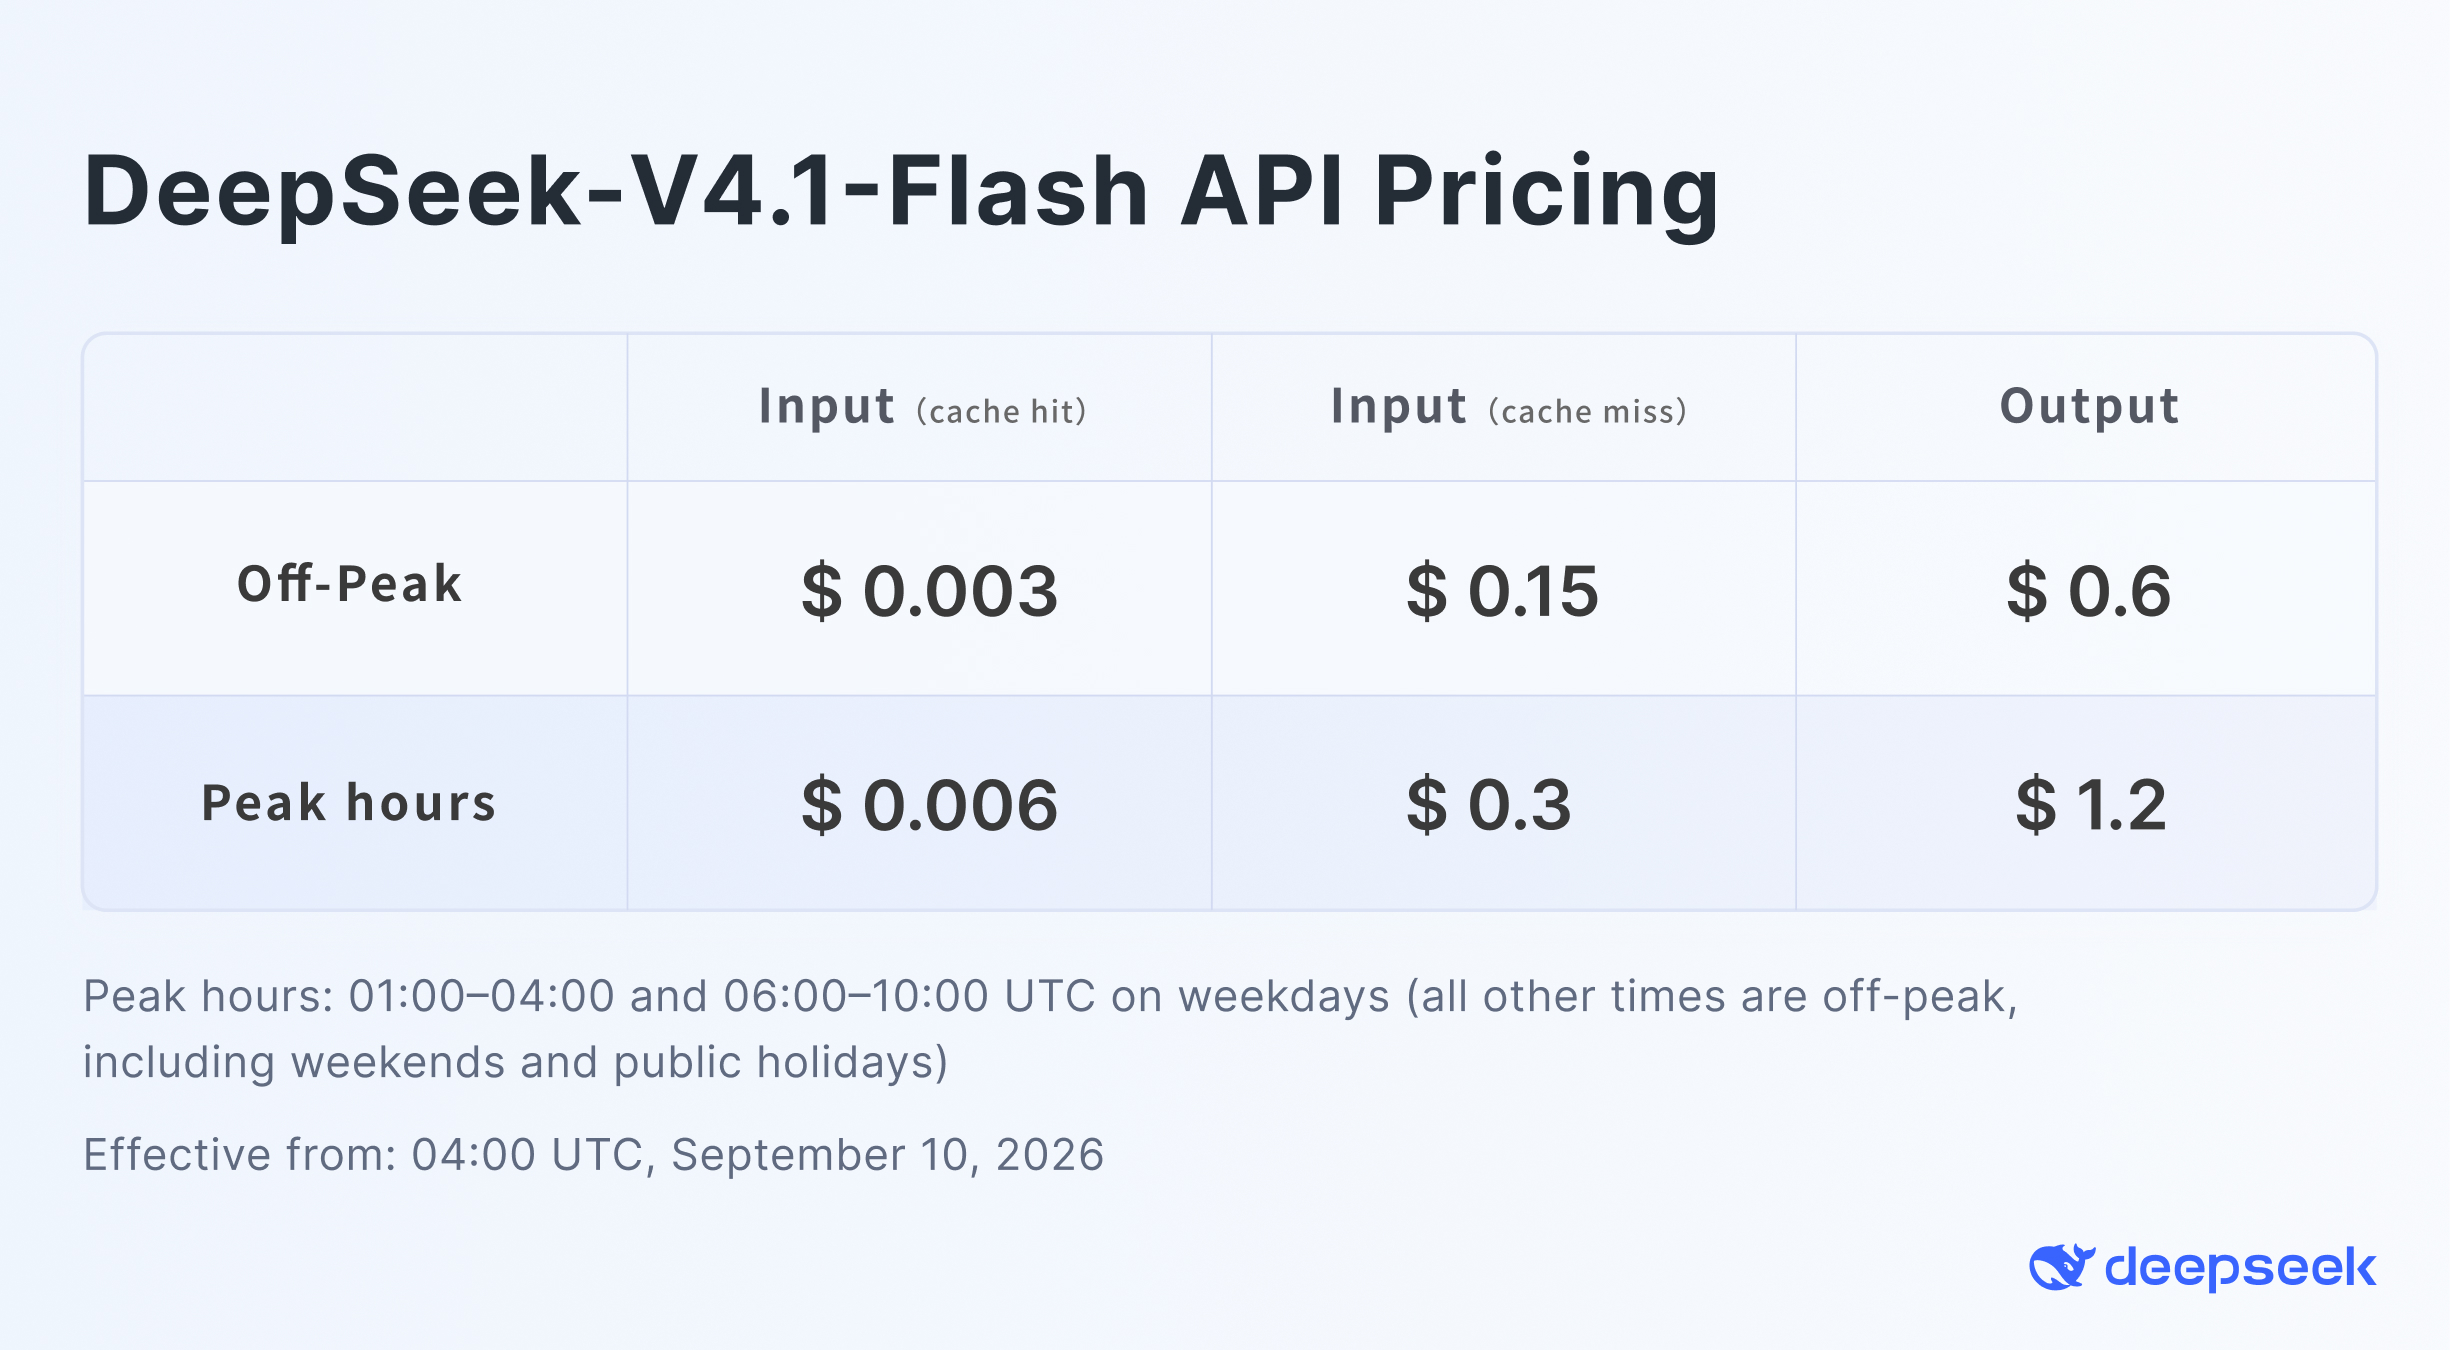
معماری کارآمدتر = قیمت API پایینتر
DeepSeek-V4.1-Flash به ما اجازه میدهد کاربران بیشتری را با هزینه کمتر سرویس دهیم و این صرفهجویی را به شما منتقل میکنیم.
- قیمتگذاری پیک/آفپیک ادامه دارد.
- نرخ آفپیک برابر با ۵۰٪ نرخ پیک است. بارهای کاری انعطافپذیر را در ساعات آفپیک اجرا کنید تا هزینه کمتری بپردازید.
- قیمتهای جدید از ساعت ۰۴:۰۰ UTC تاریخ ۱۰ سپتامبر ۲۰۲۶ اعمال شده است.
هوش مصنوعی