 آبیدرنت
بهینهسازی پایگاه داده در پروداکشن؛ راهنمای ایندکسگذاری و تیونینگ کوئریها
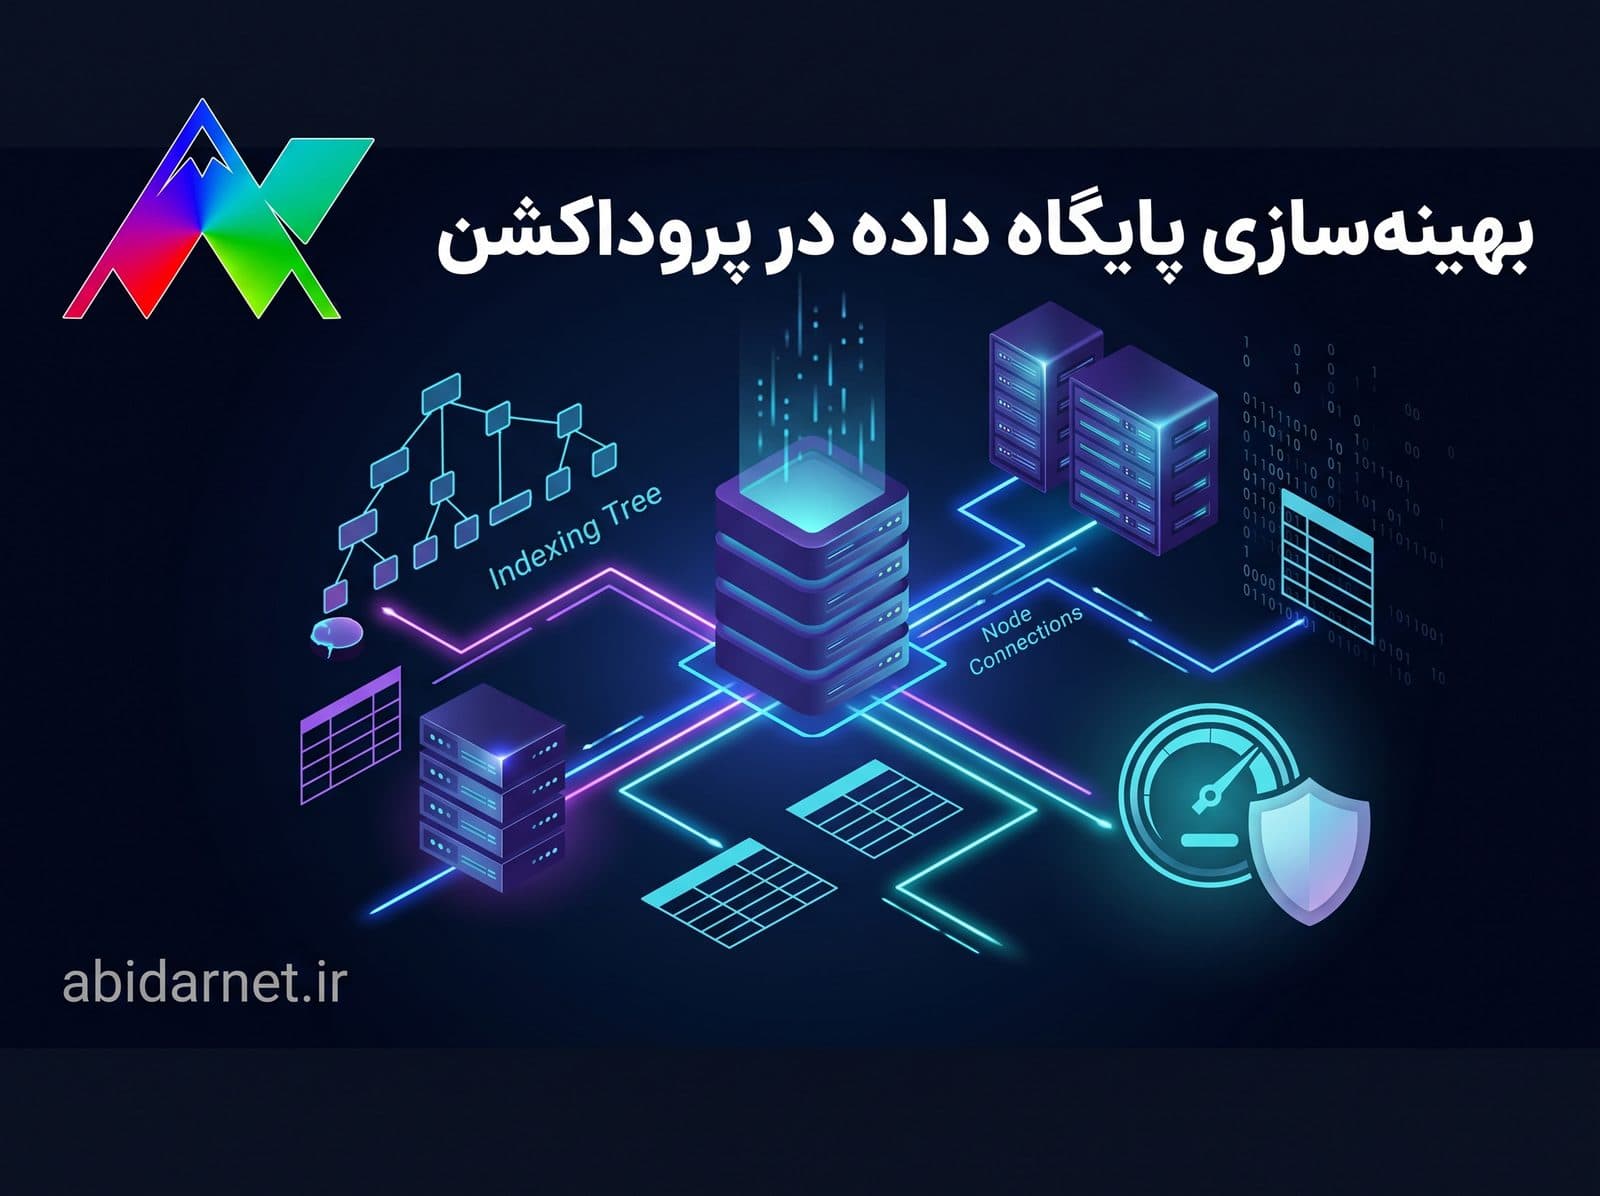
راهنمای فنی بهینهسازی پایگاه داده در محیط عملیاتی؛ بررسی استراتژیهای ایندکسگذاری پیشرفته، رفع گلوگاههای کوئریهای کند و مدیریت کانکشنها در آبیدرنت.
با رشد ترافیک یک سامانه و افزایش رکوردهای دیتابیس به صدها هزار یا میلیونها ردیف، نخستین لایهای که فشار را تحمل میکند و ممکن است کل سیستم را کند کند، پایگاه داده است. در بسیاری از پروژهها، به محض کند شدن پاسخدهی وبسرویس، اولین اقدام تیمها ارتقای سختافزاری سرور است؛ در حالی که ریشه بیش از هشتاد درصد مشکلات، به ساختار نادرست ایندکسها و کوئریهای بهینهنشده برمیگردد.
در این یادداشت فنی، بر اساس تجربیات حاصل از استقرار پایگاههای داده رابطهای در مقیاسهای پروداکشن، مهمترین اصول تیونینگ و رفع گلوگاههای دیتابیس را مرور میکنیم.
۱. خطای اسکن کامل جدول و نقش ایندکسهای هدفمند
زمانی که برای فیلتر کردن دادهها ایندکس مناسبی وجود نداشته باشد، موتور پایگاه داده ناچار است تمام صفحات داده روی دیسک را بخواند (Sequential Scan). این فرایند در جداول حجیم، باعث مصرف صددرصدی پردازنده و مسدود شدن عملیات I/O دیسک میشود:
• ایندکسهای ترکیبی (Composite Indexes): زمانی که فیلترها معمولاً روی دو یا چند ستون به طور همزمان اعمال میشوند (مانند وضعیت سفارش و تاریخ ایجاد)، ترتیب ستونها در ساخت ایندکس حیاتی است. ستونی که بیشترین تنوع داده و محدودکنندگی را دارد باید در ابتدای ایندکس قرار گیرد.
• پرهیز از ایندکسگذاری افراطی: ایندکسها سرعت خواندن داده را بالا میبرند، اما هر عملیات درج (Insert) یا ویرایش (Update) را کند میکنند، زیرا دیتابیس مجبور است ساختار درخت ایندکس را نیز بازسازی کند. ایندکسها باید صرفاً بر اساس لاگ کوئریهای واقعی ساخته شوند.
۲. کالبدشکافی کوئریها با دستور EXPLAIN ANALYZE
بهینهسازی بدون اندازهگیری دقیق، شبیه به حدس زدن در تاریکی است. استفاده از قابلیت EXPLAIN ANALYZE در دیتابیس مشخص میکند که پایگاه داده دقیقاً چگونه به دادهها دسترسی پیدا کرده است:
• تفاوت هزینه تخمینی و هزینه واقعی: بررسی زمان دقیق صرفشده در گرههای فیلتر، مرتبسازی و ادغام جداول به شما نشان میدهد گلوگاه در کدام بخش از کوئری نهفته است.
• شناسایی مرتبسازیهای سنگین روی دیسک: اگر حجم دادههای مرتبسازی (Order By) از حافظه اختصاصیافته برای هر عملیات فراتر رود، دیتابیس دادهها را به جای رم روی دیسک موقت میریزد که افت شدید سرعت را به همراه دارد.
۳. مهار مسئله خطرناک N+1 در لایه ORM
ابزارهای نگاشت شیبهرابطه (ORMها) سرعت توسعه بکاند را بالا میبرند، اما اگر بدون دقت استفاده شوند، فاجعه عملکردی ایجاد میکنند. در خطای N+1، برنامه برای دریافت یک لیست و دادههای مرتبط با آن، به جای یک کوئری منسجم، دهها یا صدها کوئری جداگانه به سرور دیتابیس ارسال میکند:
• بارگذاری پیشدستانه (Eager Loading): در واکشی دادههای رابطهای، باید همواره ارتباطات مورد نیاز در همان کوئری اولیه با JOIN یا واکشی جمعی دریافت شوند تا از رفتوبرگشتهای پرتکرار در بستر شبکه جلوگیری گردد.
• انتخاب ستونهای ضروری: درخواست دادن تمام فیلدهای جدول در روتهای عمومی، حافظه رم سرور برنامه را هدر میدهد. همیشه تنها ستونهایی که کلاینت نیاز دارد واکشی شوند.
۴. مدیریت بهینه استخر اتصالات (Connection Pooling)
باز کردن یک اتصال جدید به پایگاه داده، نیازمند احراز هویت، تخصیص حافظه و ساخت پروسه در سیستمعامل است. اگر هر ریکوئست وب اتصال اختصاصی خود را باز کند، سرور زیر بار سنگین متوقف میشود:
• استفاده از استخر کانکشن: اتصالات فعال باید به صورت اشتراکی در یک استخر (Connection Pool) نگهداری شوند و پس از اتمام تراکنش بلافاصله آزاد گردند.
• تنظیم سقف اتصالات متناسب با هستههای پردازنده: اختصاص صدها اتصال همزمان به دیتابیس باعث کاهش کارایی به دلیل جابهجایی مداوم زمینههای پردازشی (Context Switching) میشود؛ ظرفیت کانکشنها باید دقیقاً بر اساس توان واقعی پردازنده و رم سرور تنظیم گردد.
جمعبندی
پایداری و سرعت بالای وبسرویسها، نتیجه مهندسی دقیق لایه ذخیرهسازی داده است. تحلیل مستمر کوئریهای کند، ساخت ایندکسهای چندستونی حسابشده و مهار درخواستهای تکراری در لایه ORM، به دیتابیس اجازه میدهد حتی در اوج بار ترافیکی، با کمترین مصرف منابع بهترین عملکرد را ارائه دهد.